Το κείμενο εξηγεί πώς υπολογίζουμε με ολοκληρώματα δύο βασικά περιγραφικά μέτρα: τον μέσο όρο και τη μέση απόλυτη απόκλιση. Στο τέλος προσθέτει και τη διακύμανση. Ξεκινάμε από απλές συναρτήσεις, όπου το ύψος της καμπύλης είναι η τιμή. Μετά περνάμε στις πυκνότητες πιθανότητας, όπου το ύψος της καμπύλης είναι βάρος.
Τι χρειάζεται να ξέρεις: τι είναι ο μέσος όρος μιας λίστας αριθμών, και τι είναι ορισμένο ολοκλήρωμα (το εμβαδόν κάτω από μια καμπύλη), μαζί με τον υπολογισμό του για απλά πολυώνυμα, π.χ. \(\int_0^1 x^2\,dx = 1/3\). Δεν χρειάζονται πιθανότητες ούτε R. Ο κώδικας είναι κρυμμένος και ανοίγει με το «Κώδικας», μόνο αν θέλεις να δεις πώς βγήκε ένας αριθμός.
Συνοδευτικά κείμενα:
- Ο διάμεσος: έχει δικές του ιδιαιτερότητες, γι’ αυτό είναι χωριστά.
- Η κανονική κατανομή σε διάστημα: τι αλλάζει όταν κρατάμε μόνο ένα κομμάτι της καμπύλης.
Μέρος Α: απλές συναρτήσεις
Μέσος όρος των τιμών μιας συνάρτησης
Όταν έχουμε \(n\) αριθμούς \(y_1, \dots, y_n\), ο μέσος όρος είναι
$$\bar{y} = \frac{1}{n} \sum_{i=1}^{n} y_i$$Προσθέτουμε όλες τις τιμές και διαιρούμε με το πλήθος τους.
Τώρα ας πάρουμε μια συνάρτηση \(h(x)\) σε ένα διάστημα \([a, b]\). Κάθε \(x\) του διαστήματος δίνει μια τιμή \(y = h(x)\), και το ύψος της καμπύλης είναι η τιμή, όπως σε κάθε γραφική παράσταση. Δεν έχουμε όμως πλέον \(n\) μεμονωμένες τιμές. Έχουμε άπειρες, μία για κάθε \(x\). Πώς παίρνουμε τον μέσο όρο άπειρων τιμών;
Από το άθροισμα στο ολοκλήρωμα
Ξεκινάμε από αυτό που ξέρουμε. Χωρίζουμε το \([a, b]\) σε \(n\) ίσα κομμάτια, παίρνουμε από ένα \(x_i\) στο μέσο καθενός, και υπολογίζουμε τον συνηθισμένο μέσο όρο των \(n\) τιμών \(h(x_i)\).
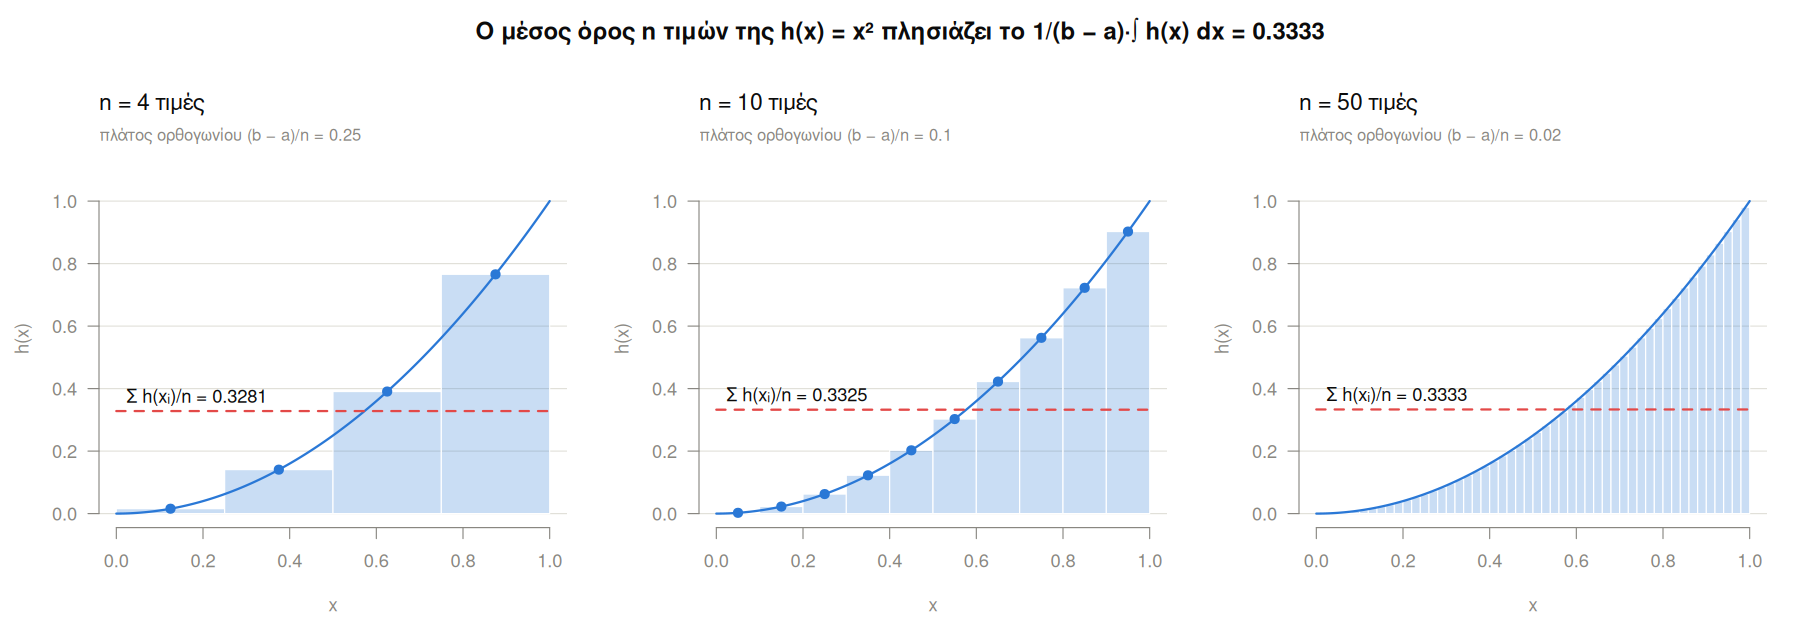
Εικόνα 1: Ο μέσος όρος \(n\) ισαπεχουσών τιμών της \(h(x) = x^2\) (κόκκινη γραμμή). Κάθε
τιμή είναι το ύψος ενός ορθογωνίου. Όσο μεγαλώνει το \(n\), ο μέσος όρος
σταθεροποιείται στο \(1/3\). (function_values.R)
Στην Εικόνα 1 κάθε τιμή \(h(x_i)\) είναι το ύψος ενός ορθογωνίου με πλάτος \(\Delta x = \frac{b-a}{n}\). Επειδή \(\frac{1}{n} = \frac{\Delta x}{b - a}\), ο μέσος όρος γράφεται:
$$\bar{y}_n = \frac{1}{n} \sum_{i=1}^{n} h(x_i) = \frac{1}{b - a} \underbrace{\sum_{i=1}^{n} h(x_i)\,\Delta x}_{\text{εμβαδόν ορθογωνίων}}$$Το άθροισμα είναι το συνολικό εμβαδόν των ορθογωνίων. Όσο μεγαλώνει το \(n\), τα ορθογώνια στενεύουν και γεμίζουν ακριβώς την περιοχή κάτω από την καμπύλη. Το άθροισμα γίνεται ολοκλήρωμα, και αυτός είναι ακριβώς ο ορισμός του ολοκληρώματος. Με \(n = 4\) τιμές ο μέσος είναι 0.3281, με 10 είναι 0.3325, με 50 είναι ήδη 0.3333:
$$\bar{y} = \frac{1}{b - a} \int_a^b h(x)\,dx$$| Διακριτές τιμές | Τιμές συνάρτησης |
|---|---|
| τιμή \(y_i\) | τιμή \(h(x)\) |
| άθροισμα \(\sum\) | ολοκλήρωμα \(\int_a^b \dots dx\) |
| διαίρεση με το πλήθος \(n\) | διαίρεση με το μήκος \(b - a\) |
Κώδικας
riemann_mean <- function(h, n) {
  xi <- (seq_len(n) - 0.5) / n     # τα μέσα των n κομματιών του [0, 1]
  mean(h(xi))
}
sapply(c(4, 10, 50, 1000), function(n) riemann_mean(function(x) x^2, n))
[1] 0.3281250 0.3325000 0.3333000 0.3333333
Τρεις συναρτήσεις
Χρησιμοποιούμε τρεις αύξουσες συναρτήσεις στο \([0, 1]\): μια ευθεία, μια που λυγίζει προς τα πάνω (κυρτή) και μια που λυγίζει προς τα κάτω (κοίλη).
Κώδικας
a <- 0
b <- 1
h_lin <- function(x) 2 * x
h_cvx <- function(x) x^2
h_ccv <- function(x) 2 * x - x^2

mean_values <- function(h) integrate(h, a, b)$value / (b - a)

c(`2x` = mean_values(h_lin), `x²` = mean_values(h_cvx), `2x − x²` = mean_values(h_ccv))
       2x        x²   2x − x²
1.0000000 0.3333333 0.6666667
Εδώ τα ολοκληρώματα βγαίνουν και με το χέρι:
$$\int_0^1 2x\,dx = 1, \qquad \int_0^1 x^2\,dx = \frac{1}{3}, \qquad \int_0^1 (2x - x^2)\,dx = 1 - \frac{1}{3} = \frac{2}{3}$$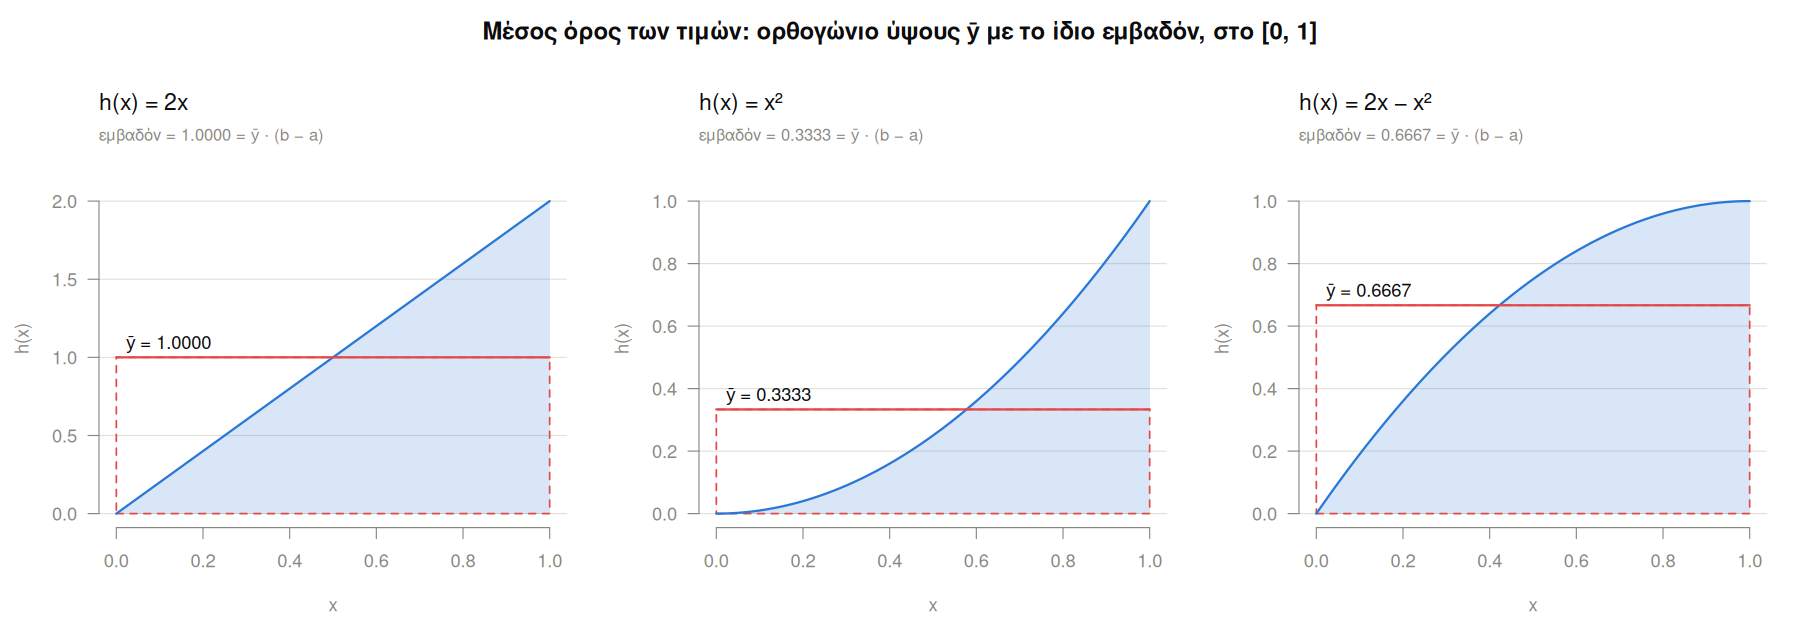
Εικόνα 2: Ο μέσος όρος των τιμών ως ορθογώνιο. Το ορθογώνιο με ύψος \(\bar{y}\) (κόκκινο)
έχει ακριβώς το ίδιο εμβαδόν με την περιοχή κάτω από την καμπύλη (μπλε).
(function_values.R)
Η Εικόνα 2 δείχνει τι σημαίνει ο τύπος γεωμετρικά. Αν πολλαπλασιάσουμε και τις δύο πλευρές με \(b - a\):
$$\bar{y} \cdot (b - a) = \int_a^b h(x)\,dx$$Αριστερά είναι το εμβαδόν ενός ορθογωνίου με ύψος \(\bar{y}\) και πλάτος \(b - a\). Δεξιά είναι το εμβαδόν κάτω από την καμπύλη. Ο μέσος όρος είναι λοιπόν το ύψος στο οποίο πρέπει να «ισιώσει» η καμπύλη ώστε να κρατήσει το ίδιο εμβαδόν. Όσο περισσεύει πάνω από την κόκκινη γραμμή, τόσο λείπει κάτω από αυτήν.
Μέση απόλυτη απόκλιση των τιμών
Ο μέσος όρος λέει πού είναι το κέντρο των τιμών. Η μέση απόλυτη απόκλιση λέει πόσο απλωμένες είναι γύρω από το κέντρο: πόσο απέχει, κατά μέσο όρο, μια τιμή από το \(\bar{y}\).
Η λογική είναι ακριβώς η ίδια με εκείνη του μέσου όρου. Στη θέση της ποσότητας \(h(x)\) βάζουμε την απόσταση \(|h(x) - \bar{y}|\) και παίρνουμε τον μέσο όρο της:
$$\text{ΜΑΑ} = \frac{1}{b - a} \int_a^b |h(x) - \bar{y}|\,dx$$Η απόλυτη τιμή είναι απαραίτητη. Χωρίς αυτήν, οι τιμές κάτω από το \(\bar{y}\) δίνουν αρνητικές διαφορές, οι οποίες αναιρούν ακριβώς τις θετικές, και το ολοκλήρωμα είναι πάντα 0:
Κώδικας
ybar <- mean_values(h_lin)
integrate(function(x) h_lin(x) - ybar, a, b)$value        # χωρίς απόλυτη τιμή
[1] 3.516356e-18
Κώδικας
integrate(function(x) abs(h_lin(x) - ybar), a, b)$value # με απόλυτη τιμή
[1] 0.5
Αυτό δεν είναι σύμπτωση. Είναι ακριβώς αυτό που είδαμε στην Εικόνα 2: ό,τι περισσεύει πάνω από το \(\bar{y}\) ισούται με ό,τι λείπει κάτω από αυτό.
Η διαδικασία σε τέσσερα βήματα
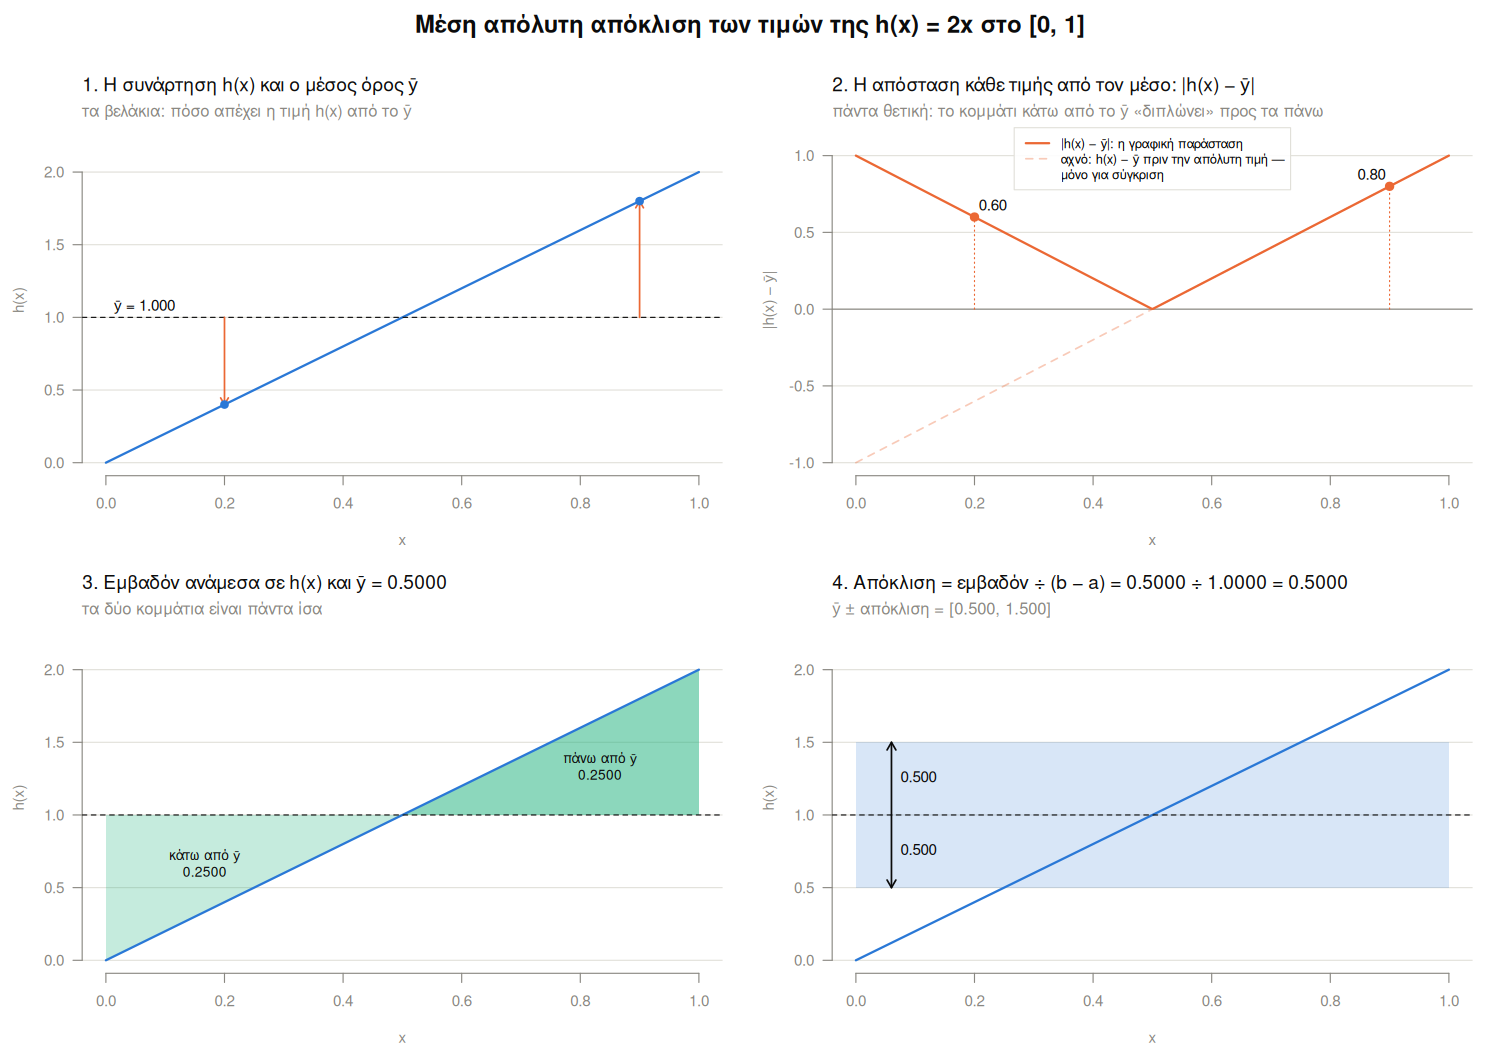
Εικόνα 3: Μέση απόλυτη απόκλιση των τιμών της \(h(x) = 2x\) βήμα-βήμα.
(function_values.R)
Η Εικόνα 3 δείχνει τον υπολογισμό για την \(h(x) = 2x\), ένα βήμα σε κάθε πάνελ:
Βήμα 1: η συνάρτηση και ο μέσος όρος (πάνω αριστερά). Η οριζόντια διακεκομμένη γραμμή είναι το \(\bar{y} = 1\). Τα πορτοκαλί βελάκια δείχνουν πόσο απέχουν από αυτό δύο τιμές: η μία είναι κάτω από το \(\bar{y}\), η άλλη πάνω.
Βήμα 2: η απόσταση \(|h(x) - \bar{y}|\) (πάνω δεξιά). Η αχνή διακεκομμένη γραμμή είναι η \(h(x) - \bar{y}\) πριν από την απόλυτη τιμή, και είναι αρνητική αριστερά. Η απόλυτη τιμή «διπλώνει» το αρνητικό κομμάτι προς τα πάνω, και έτσι σχηματίζεται το «V». Οι δύο τελείες είναι τα ίδια σημεία με τα βελάκια του βήματος 1.
Βήμα 3: το εμβαδόν ανάμεσα στην καμπύλη και στο \(\bar{y}\) (κάτω αριστερά). Είναι το ίδιο εμβαδόν με εκείνο κάτω από το «V» του βήματος 2, απλώς ζωγραφισμένο πάνω στην αρχική καμπύλη. Το κομμάτι κάτω από το \(\bar{y}\) και το κομμάτι πάνω από το \(\bar{y}\) είναι πάντα ίσα. Είναι η ιδιότητα του μέσου όρου που είδαμε μόλις.
Βήμα 4: το αποτέλεσμα (κάτω δεξιά). Διαιρούμε το εμβαδόν με το μήκος \(b - a\), όπως στον μέσο όρο. Η τιμή που βγαίνει είναι απόσταση στον άξονα \(y\). Η σκιασμένη ζώνη \(\bar{y} \pm \text{ΜΑΑ}\) δείχνει πόσο απλώνονται «τυπικά» οι τιμές.
Για την ευθεία βγαίνει και με το χέρι. Τα δύο κομμάτια είναι τρίγωνα με βάση 0.5 και ύψος 1:
$$\int_0^1 |2x - 1|\,dx = 2 \cdot \frac{0.5 \cdot 1}{2} = 0.5$$Κυρτή και κοίλη
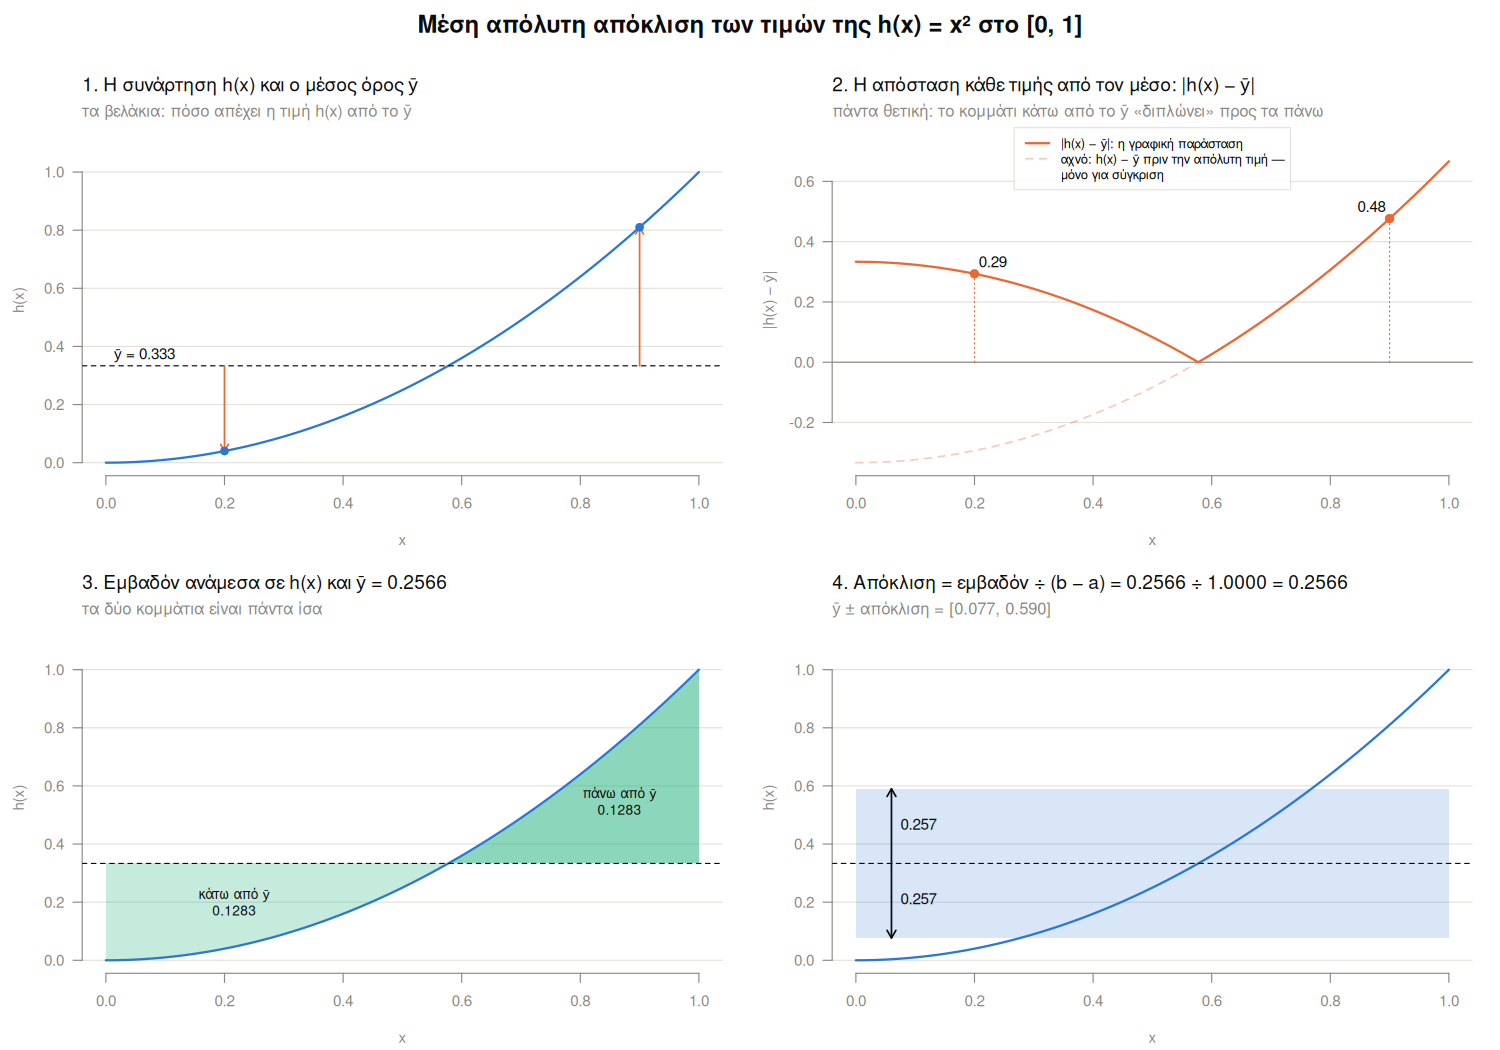
Εικόνα 4: Μέση απόλυτη απόκλιση των τιμών της \(h(x) = x^2\).
(function_values.R)
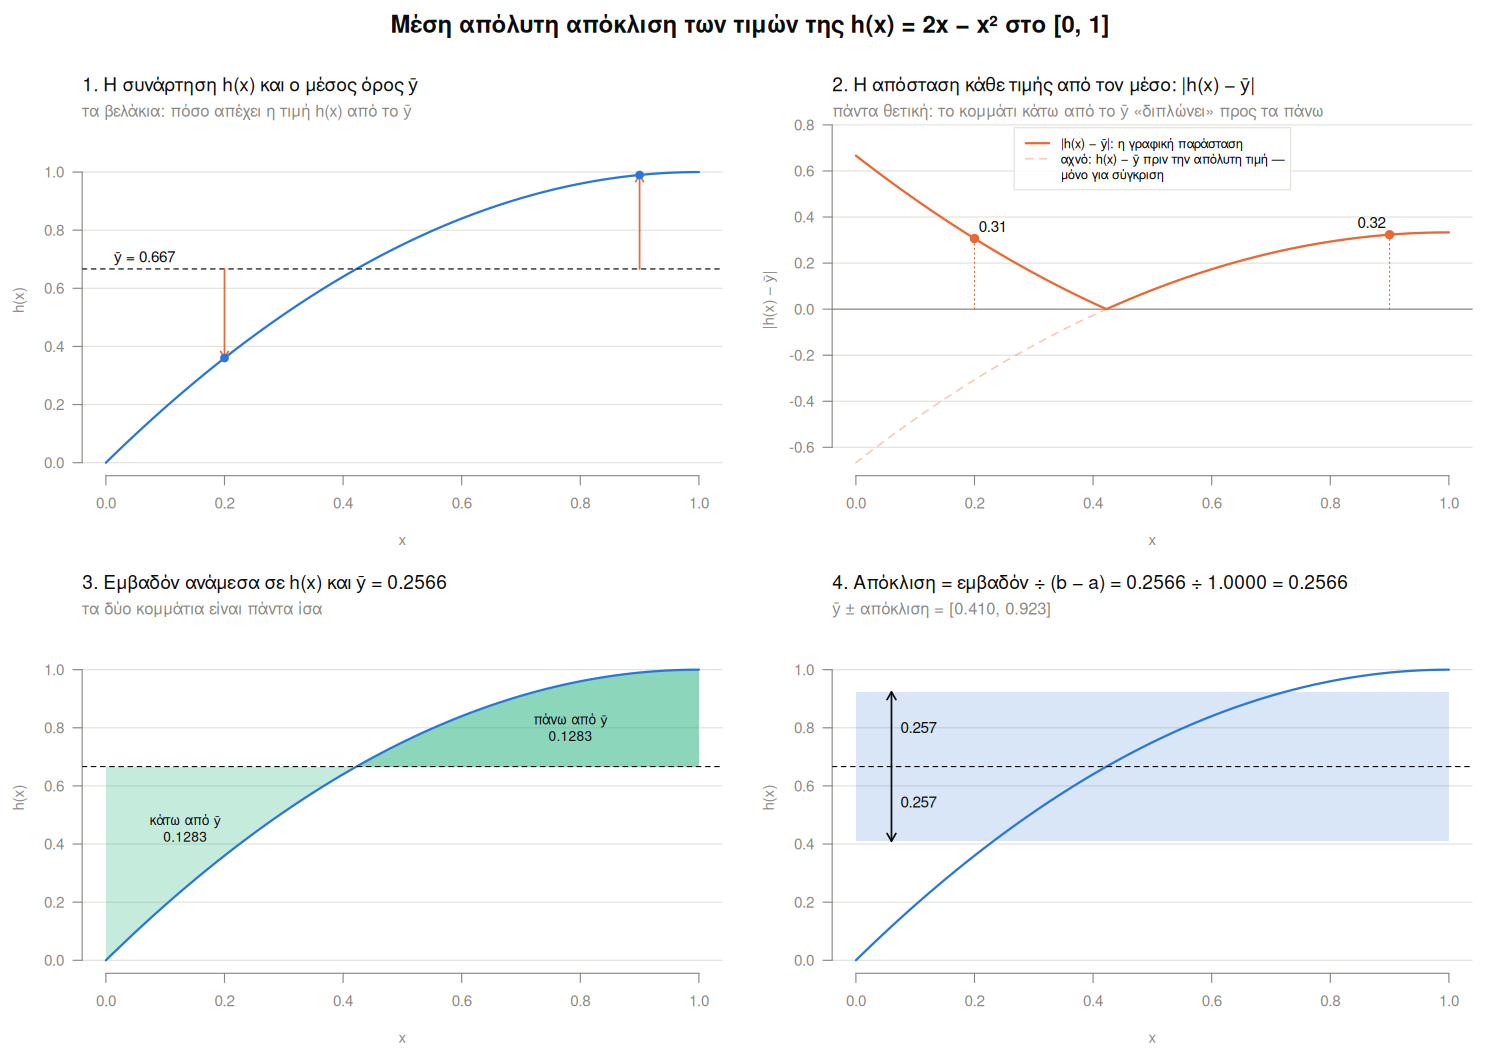
Εικόνα 5: Μέση απόλυτη απόκλιση των τιμών της \(h(x) = 2x - x^2\).
(function_values.R)
Κώδικας
# rel.tol: μεγαλύτερη ακρίβεια, γιατί η |·| έχει «γωνία» στο σημείο όπου h(x) = ȳ
mad_values <- function(h) {
  ybar <- mean_values(h)
  integrate(function(x) abs(h(x) - ybar), a, b, rel.tol = 1e-10)$value / (b - a)
}
c(`2x` = mad_values(h_lin), `x²` = mad_values(h_cvx), `2x − x²` = mad_values(h_ccv),
  `4/(9√3)` = 4 / (9 * sqrt(3)))
       2x        x²   2x − x²   4/(9√3)
0.5000000 0.2566001 0.2566001 0.2566001
Σύγκρινε το βήμα 3 της Εικόνα 4 με εκείνο της Εικόνα 5. Τα πράσινα κομμάτια έχουν ανάποδο σχήμα, αλλά ακριβώς το ίδιο εμβαδόν (0.1283 το καθένα). Γι’ αυτό οι δύο συναρτήσεις έχουν την ίδια απόκλιση, \(4/(9\sqrt{3}) \approx 0.257\).
Ο λόγος είναι ότι \(2x - x^2 = 1 - (1 - x)^2\). Η κοίλη είναι η κυρτή αναποδογυρισμένη και καθρεφτισμένη. Παίρνει τις ίδιες τιμές με ανάποδη σειρά, οπότε απλώνεται ακριβώς το ίδιο γύρω από τον μέσο της. Η απόκλιση μετράει πόσο απλωμένες είναι οι τιμές, όχι πού βρίσκονται.
Η μετάβαση: από την τιμή στο βάρος
Το \(\frac{1}{b-a}\) ήταν ήδη βάρος
Ξαναγράφουμε τον μέσο όρο των τιμών λίγο διαφορετικά, βάζοντας το \(\frac{1}{b-a}\) μέσα στο ολοκλήρωμα:
$$\bar{y} = \int_a^b h(x) \cdot \underbrace{\frac{1}{b - a}}_{\text{βάρος}}\,dx$$Τώρα διαβάζεται έτσι: κάθε τιμή \(h(x)\) πολλαπλασιάζεται με ένα βάρος \(\frac{1}{b-a}\), και το βάρος είναι ίδιο για όλα τα \(x\). Είναι ακριβώς το \(\frac{1}{n}\) του διακριτού μέσου όρου. Το συνολικό βάρος είναι 1: \(\int_a^b \frac{1}{b-a}\,dx = 1\).
Μια σταθερή συνάρτηση βάρους με συνολικό βάρος 1 είναι ήδη μια πυκνότητα πιθανότητας. Έχει και όνομα: ομοιόμορφη κατανομή στο \([a, b]\). Ό,τι κάναμε στο Μέρος Α ήταν λοιπόν ήδη στατιστική με πυκνότητα. Απλώς η πυκνότητα ήταν επίπεδη και «κρυβόταν» μέσα στο \(\frac{1}{b-a}\). Αν ο \(X\) διαλέγεται τυχαία και ομοιόμορφα από το \([a, b]\), τότε το \(\bar{y}\) είναι ο μέσος όρος της τυχαίας τιμής \(h(X)\).
Τι γίνεται αν τα βάρη δεν είναι ίσα; Αν κάποιες τιμές εμφανίζονται συχνότερα από άλλες; Τότε το βάρος γίνεται μια συνάρτηση \(f(x)\) που δεν είναι επίπεδη: μια γενική πυκνότητα πιθανότητας.
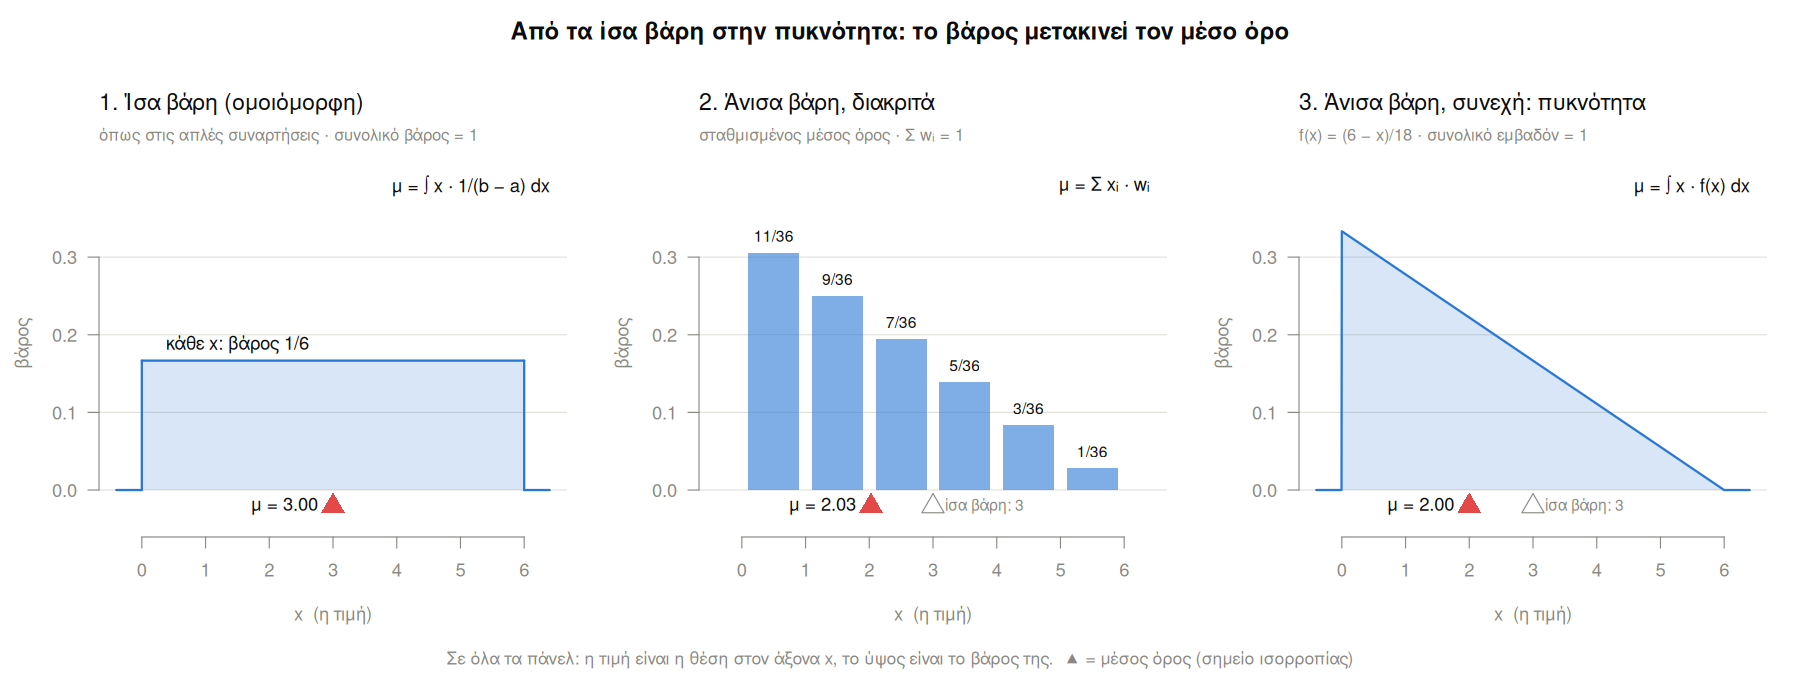
Εικόνα 6: Από τα ίσα βάρη στην πυκνότητα. Σε όλα τα πάνελ η τιμή είναι η θέση στον άξονα
\(x\) και το ύψος είναι το βάρος της. Το ▲ είναι ο μέσος όρος, το σημείο όπου
«ισορροπούν» τα βάρη. Το αχνό △ δείχνει πού ήταν με ίσα βάρη.
(bridge_visual.R)
Η Εικόνα 6 δείχνει τη μετάβαση σε τρία βήματα, όλα στο \([0, 6]\):
- Ίσα βάρη (αριστερά). Κάθε \(x\) έχει το ίδιο βάρος \(1/6\). Είναι η ομοιόμορφη κατανομή, δηλαδή η περίπτωση των απλών συναρτήσεων, σχεδιασμένη αυτή τη φορά ως βάρος. Ο μέσος όρος είναι στο κέντρο, στο 3.
- Άνισα βάρη, διακριτά (μέση). Έξι τιμές, \(0.5, 1.5, \dots, 5.5\), με βάρη \(w_i\) που μικραίνουν προς τα δεξιά. Πρόκειται για τον γνωστό σταθμισμένο μέσο όρο, όπως σε έναν πίνακα συχνοτήτων ή σε βαθμούς με συντελεστές: \(\mu = \sum x_i \cdot w_i\). Επειδή το μεγαλύτερο μέρος του βάρους είναι αριστερά, το σημείο ισορροπίας μετακινείται αριστερά, στο 2.03.
- Άνισα βάρη, συνεχή (δεξιά). Οι μπάρες γίνονται μια συνεχής γραμμή, η πυκνότητα \(f(x) = (6 - x)/18\). Το άθροισμα γίνεται ολοκλήρωμα: \(\mu = \int x \cdot f(x)\,dx = 2\).
Οι μπάρες του μεσαίου πάνελ έχουν πλάτος 1 και ύψος ίσο με την \(f\) στο μέσο τους. Είναι δηλαδή τα ορθογώνια της Εικόνα 1 για αυτή την πυκνότητα. Γι’ αυτό ο μέσος τους (2.03) είναι ήδη πολύ κοντά στο ακριβές 2, και θα πλησίαζε κι άλλο με στενότερες μπάρες.
Ο τρόπος υπολογισμού μένει ο ίδιος σε όλα τα πάνελ: τιμή επί βάρος, και άθροισμα ή ολοκλήρωμα. Αυτό που αλλάζει είναι το σχήμα του βάρους, και αυτό μετακινεί τον μέσο όρο.
Κώδικας
xi <- seq(0.5, 5.5, by = 1)
wi <- (12 - 2 * xi) / 36                       # 11/36, 9/36, ..., 1/36
f_dec <- function(x) (6 - x) / 18
c(`ίσα βάρη` = integrate(function(x) x / 6, 0, 6)$value,
  `Σ xᵢ·wᵢ` = sum(xi * wi),
  `∫ x·f(x) dx` = integrate(function(x) x * f_dec(x), 0, 6)$value)
   ίσα βάρη     Σ xᵢ·wᵢ ∫ x·f(x) dx
   3.000000    2.027778    2.000000
Προσοχή: αλλάζει ο ρόλος του άξονα \(y\)
Αυτό είναι το σημείο όπου μπερδεύεται κανείς πιο εύκολα:
| Απλή συνάρτηση \(h(x)\) | Πυκνότητα \(f(x)\) | |
|---|---|---|
| η τιμή είναι | το ύψος \(h(x)\), στον άξονα \(y\) | η θέση \(x\), στον άξονα \(x\) |
| το βάρος είναι | σταθερό, \(\frac{1}{b-a}\) (δεν σχεδιάζεται) | το ύψος \(f(x)\), στον άξονα \(y\) |
| μέσος όρος | \(\int h(x) \cdot \frac{1}{b-a}\,dx\) | \(\int x \cdot f(x)\,dx\) |
Στην πυκνότητα το ύψος της καμπύλης δεν είναι τιμή. Γι’ αυτό, όταν θέλουμε την απόσταση από τον μέσο όρο, αφαιρούμε το \(\mu\) από το \(x\), όχι από το \(f(x)\). Το \(f(x) - \mu\) απλώς θα κατέβαζε την καμπύλη προς τα κάτω και δεν θα μετρούσε καμία απόσταση.
Μια ακόμη διευκρίνιση: το \(f(x)\) δεν είναι η πιθανότητα να πάρει το \(X\) την τιμή \(x\). Σε μια συνεχή κατανομή, η πιθανότητα μιας ακριβούς τιμής είναι 0. Η πιθανότητα αφορά ένα διάστημα και είναι το εμβαδόν κάτω από την καμπύλη:
$$P(u \le X \le v) = \int_u^v f(x)\,dx$$Γι’ αυτό το ύψος \(f(x)\) μπορεί ακόμη και να είναι μεγαλύτερο από 1, χωρίς πρόβλημα. Σημασία έχει το συνολικό εμβαδόν, δηλαδή το συνολικό βάρος, να είναι 1.1
Και οι δύο στήλες είναι περιπτώσεις του ίδιου τύπου:
$$\int (\text{ποσότητα}) \cdot (\text{βάρος})\,dx$$Στις απλές συναρτήσεις η ποσότητα είναι \(h(x)\) και το βάρος σταθερό (ομοιόμορφη κατανομή). Στις πυκνότητες η ποσότητα είναι απλώς το \(x\) και το βάρος είναι η \(f(x)\).
Μέρος Β: πυκνότητες πιθανότητας
Η τυπική κανονική κατανομή
Μια συνάρτηση \(f(x)\) είναι έγκυρη πυκνότητα αν \(f(x) \ge 0\) και το συνολικό βάρος, δηλαδή το εμβαδόν κάτω από την καμπύλη, είναι 1:
$$\int_{-\infty}^{\infty} f(x)\,dx = 1$$Η πιο γνωστή πυκνότητα είναι η τυπική κανονική κατανομή \(N(0, 1)\), η γνωστή «καμπάνα»:
$$f(x) = \frac{1}{\sqrt{2\pi}}\, e^{-x^2/2}$$Κώδικας
f <- function(x) (1 / sqrt(2 * pi)) * exp(-x^2 / 2)

integrate(f, -Inf, Inf)$value                      # συνολικό βάρος
[1] 1
Κώδικας
mu <- integrate(function(x) x * f(x), -Inf, Inf)$value
mu                                                  # μέσος όρος
[1] 0
Η integrate() της R υπολογίζει αριθμητικά ορισμένα ολοκληρώματα, ακόμα και με
όρια \(\pm\infty\). Ο μέσος όρος είναι 0 (με ακρίβεια υπολογιστή), γιατί η καμπύλη
είναι συμμετρική γύρω από το 0. Τα βάρη αριστερά και δεξιά ισορροπούν.
Μέση απόλυτη απόκλιση πυκνότητας
Ο τύπος είναι ο ίδιος με των απλών συναρτήσεων. Αλλάζουν μόνο η ποσότητα (απόσταση του \(x\) από το \(\mu\)) και το βάρος (\(f(x)\) αντί για \(\frac{1}{b-a}\)):
$$\text{ΜΑΑ} = \int |x - \mu| \cdot f(x)\,dx$$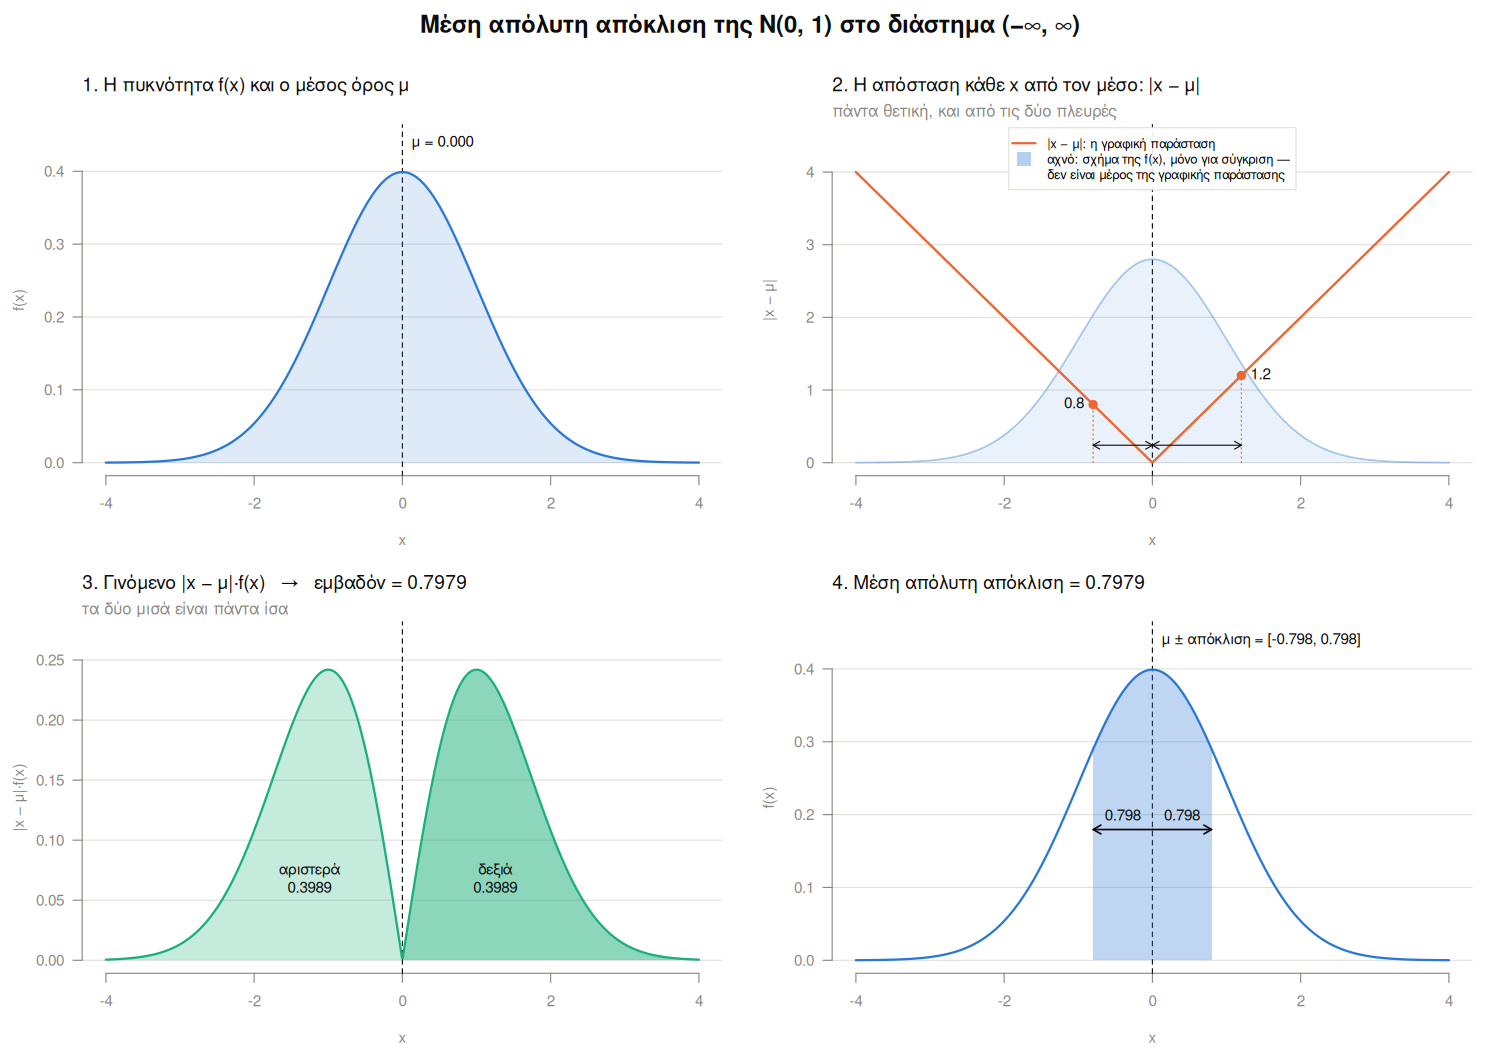
Εικόνα 7: Μέση απόλυτη απόκλιση της \(N(0, 1)\) βήμα-βήμα.
(mad_visual.R)
Η Εικόνα 7 έχει τα ίδια τέσσερα βήματα με την Εικόνα 3. Επειδή όμως η τιμή είναι τώρα στον άξονα \(x\), όλα είναι «γυρισμένα»:
Βήμα 1: πυκνότητα και μέσος όρος (πάνω αριστερά). Ο μέσος όρος είναι τώρα κάθετη γραμμή, γιατί είναι θέση στον άξονα \(x\).
Βήμα 2: η απόσταση \(|x - \mu|\) (πάνω δεξιά). Ένα «V» με κορυφή στο \(\mu\). Αυτό το πάνελ δεν εξαρτάται από την κατανομή, μόνο από το \(\mu\). Είναι ο «χάρακας» με τον οποίο μετράμε. Η αχνή μπλε καμπύλη από πίσω δεν είναι μέρος της γραφικής παράστασης. Μπαίνει μόνο για σύγκριση, για να φαίνεται ποιες αποστάσεις θα έχουν μεγάλο βάρος στο επόμενο βήμα.
Βήμα 3: το γινόμενο \(|x - \mu| \cdot f(x)\) (κάτω αριστερά). Εδώ το βάρος δεν είναι σταθερό, οπότε πρέπει πράγματι να πολλαπλασιάσουμε. Το σχήμα με τις δύο «καμπούρες» βγαίνει από τη σύγκριση του βήματος 2:
- κοντά στο \(\mu\) το βάρος είναι μεγάλο αλλά η απόσταση σχεδόν 0,
- μακριά από το \(\mu\) η απόσταση είναι μεγάλη αλλά το βάρος σχεδόν 0,
- στη μέση και τα δύο είναι «αρκετά» μεγάλα, και εκεί είναι οι κορυφές.
Το αριστερό και το δεξί μισό είναι πάλι ίσα, για τον ίδιο λόγο με πριν.
Βήμα 4: το αποτέλεσμα (κάτω δεξιά). Η απόκλιση είναι απόσταση στον άξονα \(x\), και η ζώνη \(\mu \pm \text{ΜΑΑ}\) είναι τώρα κάθετη.
Κώδικας
mad_normal <- integrate(function(x) abs(x - mu) * f(x), -Inf, Inf)$value
c(mad = mad_normal, `√(2/π)` = sqrt(2 / pi))
      mad    √(2/π)
0.7978846 0.7978846
Μια δεύτερη πυκνότητα: το τρίγωνο
Για να φανεί ότι η μέθοδος δεν αφορά μόνο την κανονική, παίρνουμε μια τριγωνική πυκνότητα: ισοσκελές τρίγωνο με κορυφή στο 0, από το \(-1\) έως το \(+1\).
$$f(x) = 1 - |x|, \qquad -1 \le x \le 1$$Το εμβαδόν είναι βάση × ύψος / 2 \(= 2 \cdot 1 / 2 = 1\), άρα είναι ήδη πυκνότητα.
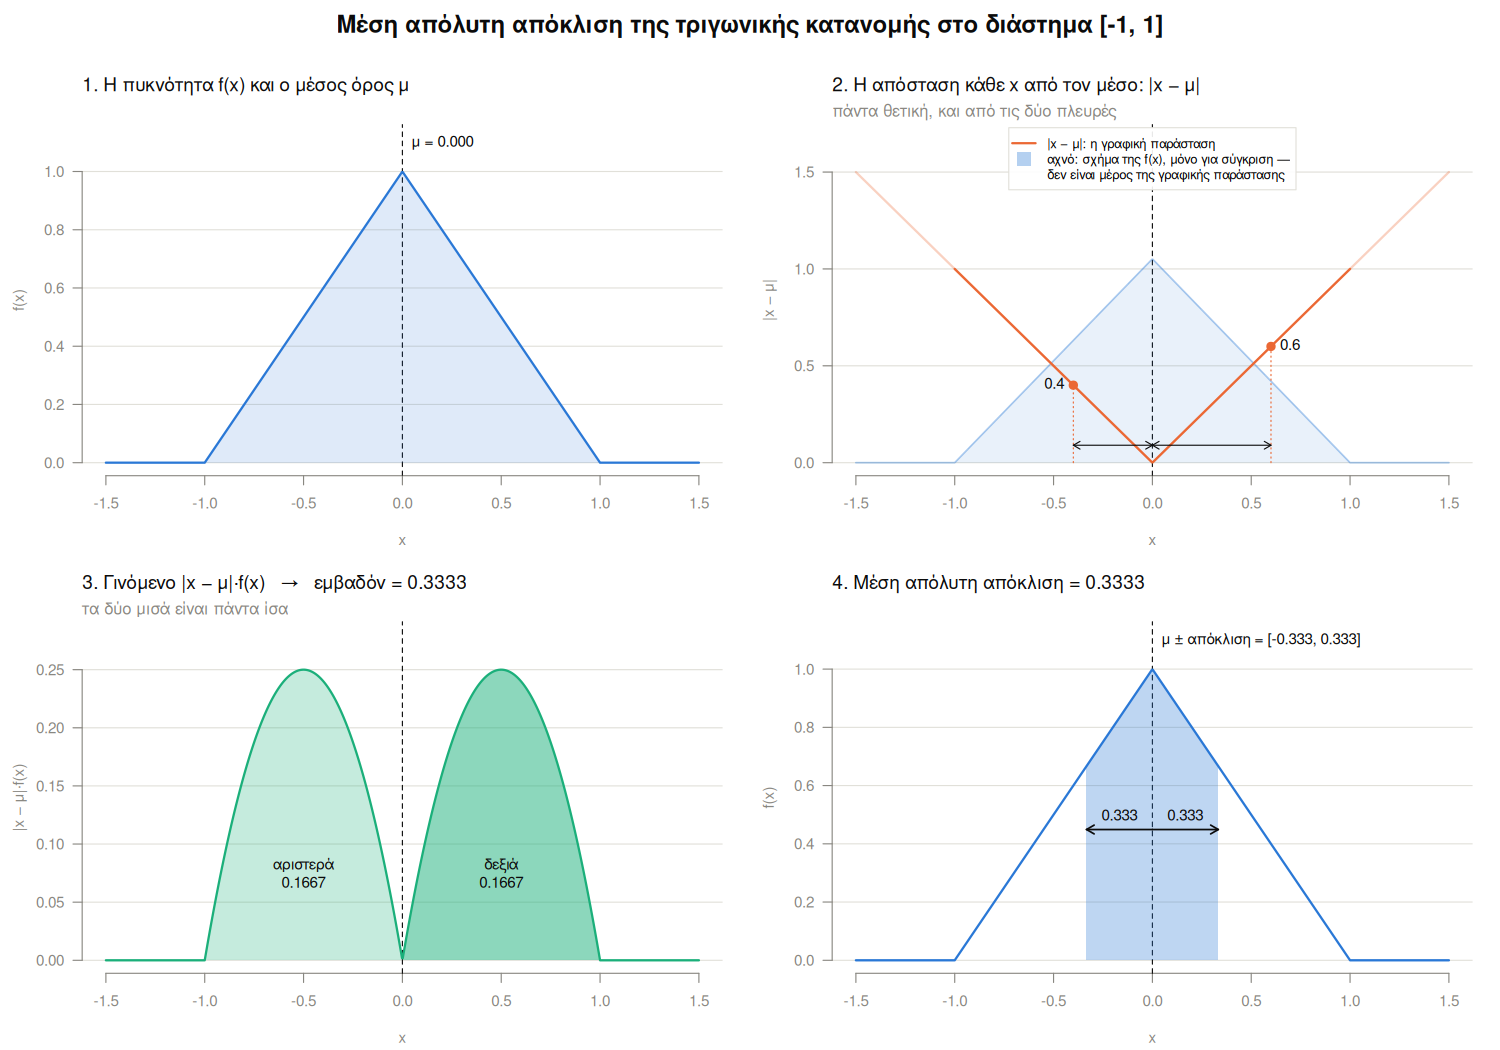
Εικόνα 8: Μέση απόλυτη απόκλιση της τριγωνικής κατανομής.
(mad_visual.R)
Σύγκρινε το βήμα 2 με εκείνο της Εικόνα 7. Το πορτοκαλί «V» είναι το ίδιο, γιατί και οι δύο κατανομές έχουν \(\mu = 0\). Αλλάζει μόνο το αχνό σχήμα από πίσω, τρίγωνο αντί για καμπάνα. Η διαφορά των κατανομών εμφανίζεται στο βήμα 3, όπου το γινόμενο \(|x|(1 - |x|)\) δίνει δύο παραβολές. Εδώ το ολοκλήρωμα βγαίνει και με το χέρι:
$$\int_{-1}^{1} |x|\,(1 - |x|)\,dx = 2 \int_{0}^{1} (x - x^2)\,dx = 2 \left( \frac{1}{2} - \frac{1}{3} \right) = \frac{1}{3}$$Κώδικας
triangle <- function(x) pmax(1 - abs(x), 0)
mu_tri   <- integrate(function(x) x * triangle(x), -1, 1)$value
integrate(function(x) abs(x - mu_tri) * triangle(x), -1, 1)$value
[1] 0.3333333
Επέκταση: διακύμανση
Ίδιο μοτίβο, με τετράγωνο
Η διακύμανση μετράει κι αυτή πόσο απλωμένες είναι οι τιμές. Στη θέση της απόλυτης τιμής χρησιμοποιεί το τετράγωνο της απόστασης:
$$\text{απλή συνάρτηση: } \frac{1}{b-a} \int_a^b (h(x) - \bar{y})^2\,dx \qquad\qquad \text{πυκνότητα: } \sigma^2 = \int (x - \mu)^2 \cdot f(x)\,dx$$Το τετράγωνο κάνει κι αυτό όλες τις αποστάσεις θετικές, αλλά δίνει πολύ μεγαλύτερο βάρος στις μεγάλες. Μια απόσταση 3 μετράει 9, ενώ μια απόσταση 0.5 μετράει 0.25. Επειδή το αποτέλεσμα είναι σε «τετραγωνισμένες» μονάδες, παίρνουμε συνήθως τη ρίζα του, την τυπική απόκλιση \(\sigma = \sqrt{\sigma^2}\), για να γυρίσουμε στις μονάδες του \(x\).
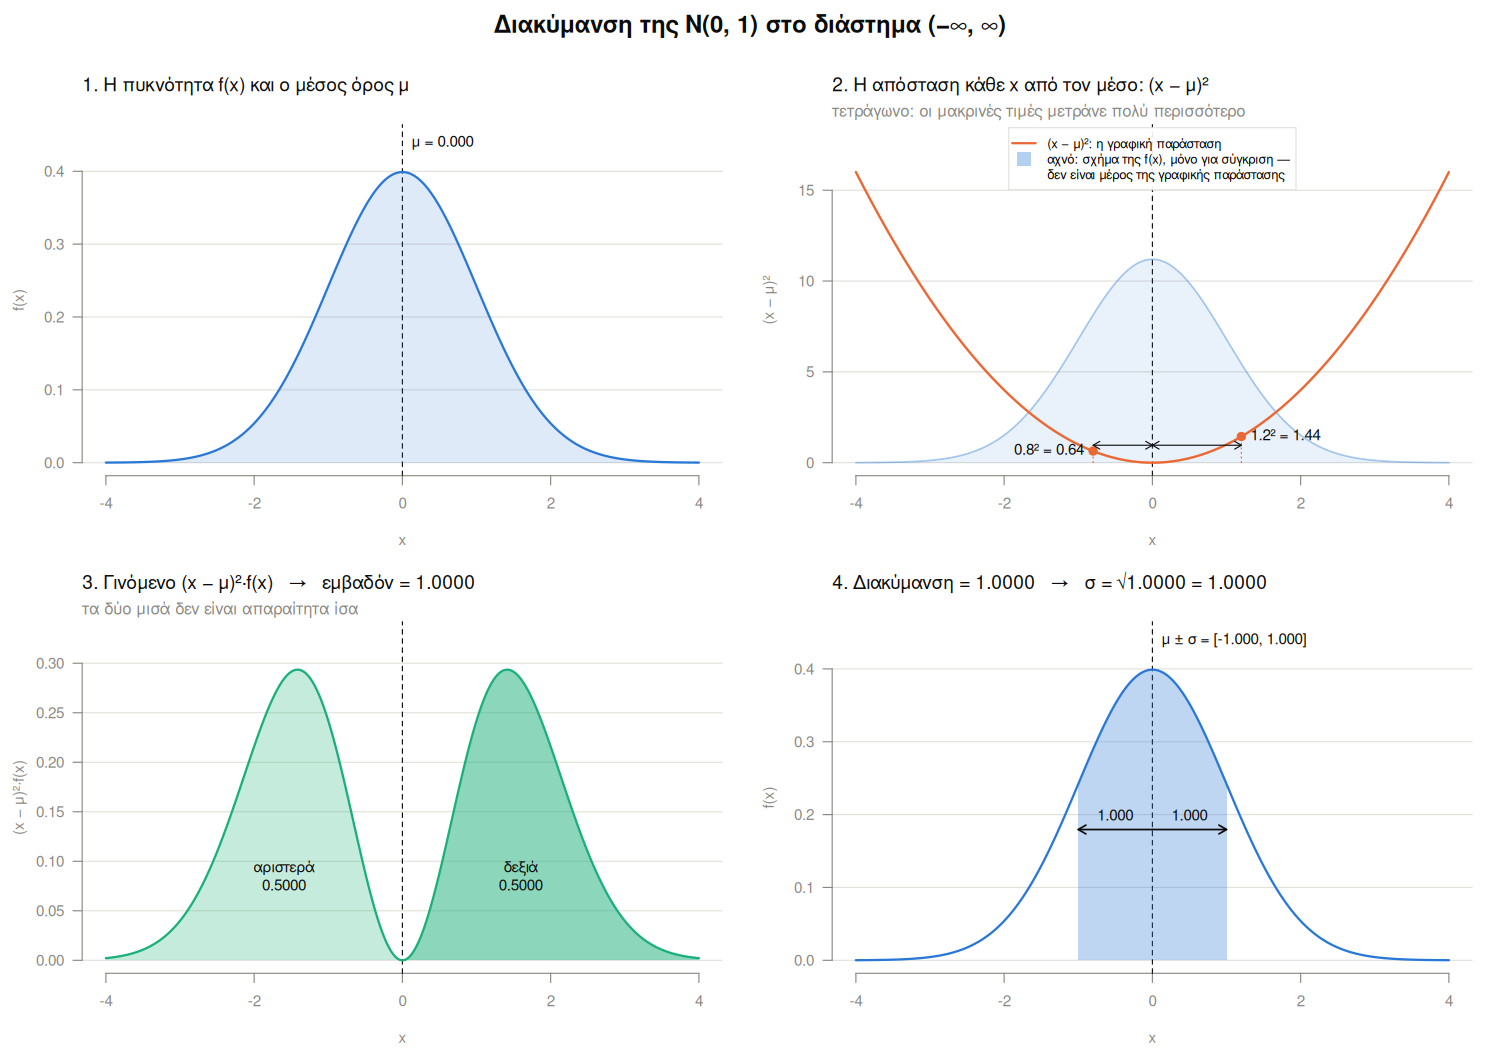
Εικόνα 9: Διακύμανση της \(N(0, 1)\) βήμα-βήμα.
(mad_visual.R)
Η Εικόνα 9 έχει τα ίδια τέσσερα βήματα με την Εικόνα 7:
- Στο βήμα 2 το «V» γίνεται παραβολή \((x - \mu)^2\), που ανεβαίνει πολύ πιο απότομα μακριά από το \(\mu\).
- Στο βήμα 3 οι καμπούρες απομακρύνονται από το κέντρο, στο \(\pm\sqrt{2}\) αντί για \(\pm 1\). Οι μακρινές τιμές μετράνε περισσότερο.
- Τα δύο μισά εδώ είναι ίσα μόνο επειδή η κανονική είναι συμμετρική. Στη διακύμανση αυτό δεν ισχύει γενικά. Το συνοδευτικό κείμενο για το διάστημα δείχνει μια περίπτωση στην οποία διαφέρουν.
- Στο βήμα 4 η ζώνη είναι \(\mu \pm \sigma\).
Κώδικας
var_values <- function(h) {
  ybar <- mean_values(h)
  integrate(function(x) (h(x) - ybar)^2, a, b)$value / (b - a)
}
var_density <- function(dens, lo, hi) {
  m <- integrate(function(x) x * dens(x), lo, hi)$value
  integrate(function(x) (x - m)^2 * dens(x), lo, hi)$value
}
c(`2x` = var_values(h_lin), `x²` = var_values(h_cvx), `2x − x²` = var_values(h_ccv),
  `N(0, 1)` = var_density(f, -Inf, Inf), `τρίγωνο` = var_density(triangle, -1, 1))
        2x         x²    2x − x²    N(0, 1)    τρίγωνο
0.33333333 0.08888889 0.08888889 1.00000000 0.16666667
Με το χέρι: για το \(2x\) είναι \(\int_0^1 (2x - 1)^2\,dx = 1/3\). Για το \(x^2\) είναι \(\int_0^1 x^4\,dx - (1/3)^2 = 1/5 - 1/9 = 4/45\), και το ίδιο για το \(2x - x^2\), για τον ίδιο λόγο με την απόκλιση. Για το τρίγωνο είναι \(2\int_0^1 x^2(1 - x)\,dx = 1/6\).
Γιατί η διακύμανση χρησιμοποιείται πιο συχνά
Η μέση απόλυτη απόκλιση είναι ευκολότερη στην ερμηνεία: είναι απλώς η μέση απόσταση από τον μέσο όρο. Στην πράξη όμως η διακύμανση και η τυπική απόκλιση χρησιμοποιούνται πολύ περισσότερο, για τρεις λόγους:
- Το τετράγωνο δεν έχει «γωνία». Η \(|x - \mu|\) σπάει απότομα στο \(\mu\), ενώ η \((x - \mu)^2\) είναι ομαλή. Οι πράξεις γίνονται πιο εύκολες. Π.χ. αναπτύσσοντας το τετράγωνο προκύπτει ο σύντομος τύπος \(\sigma^2 = \int x^2 f(x)\,dx - \mu^2\), που χρησιμοποιήσαμε παραπάνω για το \(x^2\) (\(1/5 - 1/9\)). Για την απόλυτη τιμή δεν υπάρχει αντίστοιχος τύπος, και πρέπει να σπάσουμε το ολοκλήρωμα στο σημείο όπου αλλάζει πρόσημο.
- Οι διακυμάνσεις προστίθενται. Αν δύο τυχαία μεγέθη είναι ανεξάρτητα, η διακύμανση του αθροίσματός τους είναι το άθροισμα των διακυμάνσεών τους. Για τη μέση απόλυτη απόκλιση δεν ισχύει κάτι τέτοιο.
- Το \(\sigma\) είναι η παράμετρος της κανονικής. Η κανονική γράφεται \(N(\mu, \sigma^2)\), και περίπου το 68% του βάρους της είναι στο \(\mu \pm \sigma\) και το 95% στο \(\mu \pm 2\sigma\).
Η μέση απόλυτη απόκλιση έχει ένα πλεονέκτημα: επηρεάζεται λιγότερο από ακραίες τιμές, γιατί δεν τις υψώνει στο τετράγωνο. Για την κανονική τα δύο μέτρα είναι ανάλογα: \(\text{ΜΑΑ} = \sigma \sqrt{2/\pi} \approx 0.8\,\sigma\).
Διακύμανση και τυπική απόκλιση: τι είναι τι
Τα δύο μεγέθη συνδέονται στενά, αλλά δεν είναι το ίδιο:
- Η διακύμανση είναι το \(\sigma^2\): ο μέσος όρος των τετραγώνων των αποστάσεων από τον μέσο όρο. Μετριέται σε τετραγωνισμένες μονάδες.
- Η τυπική απόκλιση είναι το \(\sigma = \sqrt{\sigma^2}\): η τετραγωνική ρίζα της διακύμανσης. Μετριέται στις ίδιες μονάδες με τις τιμές και εκφράζει μια τυπική απόσταση από τον μέσο όρο.
Για παράδειγμα, αν η διακύμανση είναι \(\sigma^2 = 4\), η τυπική απόκλιση είναι \(\sigma = 2\). Στην \(N(0, 1)\) και τα δύο έχουν αριθμητική τιμή 1, αλλά αυτό είναι ειδική περίπτωση: το πρώτο είναι \(\sigma^2 = 1\) και το δεύτερο \(\sigma = 1\).
Σύνοψη
Όλα τα μέτρα του κειμένου είναι ένας τύπος:
$$\int (\text{ποσότητα}) \cdot (\text{βάρος})\,dx$$| Μέτρο | Ποσότητα | Απλή συνάρτηση (ομοιόμορφο βάρος \(\frac{1}{b-a}\)) | Πυκνότητα (βάρος \(f(x)\)) |
|---|---|---|---|
| Μέσος όρος | η τιμή | \(h(x)\) | \(x\) |
| Μέση απόλυτη απόκλιση | η απόσταση από τον μέσο | \(\lvert h(x) - \bar{y} \rvert\) | \(\lvert x - \mu \rvert\) |
| Διακύμανση | το τετράγωνο της απόστασης | \((h(x) - \bar{y})^2\) | \((x - \mu)^2\) |
Κώδικας
describe_values <- function(h) {
  c(mean_values(h), mad_values(h), var_values(h))
}
describe_density <- function(dens, lo, hi) {
  m <- integrate(function(x) x * dens(x), lo, hi)$value
  c(m, integrate(function(x) abs(x - m) * dens(x), lo, hi, rel.tol = 1e-10)$value,
    var_density(dens, lo, hi))
}
tab <- rbind(
  `h(x) = 2x στο [0, 1]`      = describe_values(h_lin),
  `h(x) = x² στο [0, 1]`      = describe_values(h_cvx),
  `h(x) = 2x − x² στο [0, 1]` = describe_values(h_ccv),
  `πυκνότητα N(0, 1)`         = describe_density(f, -Inf, Inf),
  `πυκνότητα τρίγωνο`         = describe_density(triangle, -1, 1)
)
colnames(tab) <- c("Μέσος όρος", "Μέση απόλυτη απόκλιση", "Διακύμανση")
knitr::kable(round(tab, 4))
| Μέσος όρος | Μέση απόλυτη απόκλιση | Διακύμανση | |
|---|---|---|---|
| h(x) = 2x στο \[0, 1\] | 1.0000 | 0.5000 | 0.3333 |
| h(x) = x² στο \[0, 1\] | 0.3333 | 0.2566 | 0.0889 |
| h(x) = 2x − x² στο \[0, 1\] | 0.6667 | 0.2566 | 0.0889 |
| πυκνότητα N(0, 1) | 0.0000 | 0.7979 | 1.0000 |
| πυκνότητα τρίγωνο | 0.0000 | 0.3333 | 0.1667 |
Πίνακας 1: Όλα τα αποτελέσματα του κειμένου, υπολογισμένα με ολοκληρώματα.
Ασκήσεις
Δοκίμασε πρώτα με το χέρι, και μετά άνοιξε τη λύση για να ελέγξεις.
1. Μισές τιμές. Υπολόγισε τον μέσο όρο και τη μέση απόλυτη απόκλιση των τιμών της \(h(x) = x\) στο \([0, 1]\). Σύγκρινε με το \(2x\). Μπορείς να προβλέψεις το αποτέλεσμα χωρίς ολοκλήρωμα;
Λύση
\(\bar{y} = \int_0^1 x\,dx = 1/2\) και \(\text{ΜΑΑ} = \int_0^1 |x - 1/2|\,dx = 1/4\). Είναι ακριβώς τα μισά από το \(2x\) (1 και 0.5). Όταν όλες οι τιμές μειώνονται στο μισό, το ίδιο συμβαίνει στο κέντρο και σε κάθε απόσταση από αυτό. Η διακύμανση όμως γίνεται το ένα τέταρτο (\(1/12\) αντί για \(1/3\)), γιατί μετράει τετράγωνα αποστάσεων.
2. Μετατόπιση. Τι γίνεται με τον μέσο όρο και την απόκλιση για το \(h(x) = 2x + 5\) στο \([0, 1]\);
Λύση
Ο μέσος όρος ανεβαίνει κατά 5 (\(\bar{y} = 6\)), αλλά η απόκλιση μένει ίδια (0.5). Όλη η καμπύλη ανεβαίνει μαζί με την κόκκινη γραμμή, οπότε οι αποστάσεις από αυτήν δεν αλλάζουν. Η απόκλιση μετράει πόσο απλωμένες είναι οι τιμές, όχι πού βρίσκονται.
3. Πιο κυρτή. Πρόβλεψε αν ο μέσος όρος των τιμών της \(h(x) = x^3\) στο \([0, 1]\) θα είναι μεγαλύτερος ή μικρότερος από του \(x^2\) (\(1/3\)). Μετά υπολόγισε τον μέσο όρο και τη μέση απόλυτη απόκλιση.
Λύση
Το \(x^3\) μένει χαμηλά ακόμα περισσότερο, οπότε ο μέσος είναι μικρότερος: \(\bar{y} = \int_0^1 x^3\,dx = 1/4\).
Για την απόκλιση, η καμπύλη περνάει το \(\bar{y}\) στο \(x_* = (1/4)^{1/3} \approx 0.630\). Το κομμάτι κάτω από το \(\bar{y}\) έχει εμβαδόν
$$\int_0^{x_*} \left(\tfrac{1}{4} - x^3\right) dx = \frac{x_*}{4} - \frac{x_*^4}{4} = \frac{x_*}{4}\left(1 - \frac{1}{4}\right) = \frac{3 x_*}{16}$$και, επειδή τα δύο κομμάτια είναι ίσα, \(\text{ΜΑΑ} = 2 \cdot \frac{3 x_*}{16} = \frac{3 x_*}{8} \approx 0.236\).
Κώδικας
c(mean = integrate(function(x) x^3, 0, 1)$value,
  mad  = integrate(function(x) abs(x^3 - 1/4), 0, 1, rel.tol = 1e-10)$value)
     mean       mad
0.2500000 0.2362352
4. Ίδιος τύπος, άλλος ρόλος. Η \(f(x) = 2x\) στο \([0, 1]\) είναι έγκυρη πυκνότητα; Αν ναι, υπολόγισε τον μέσο όρο της και σύγκρινέ τον με τον μέσο όρο των τιμών της \(h(x) = 2x\) (που είναι 1). Γιατί διαφέρουν;
Λύση
Είναι έγκυρη: \(2x \ge 0\) και \(\int_0^1 2x\,dx = 1\). Ο μέσος όρος της είναι
$$\mu = \int_0^1 x \cdot 2x\,dx = \frac{2}{3}$$Διαφέρει από το 1 επειδή το «\(2x\)» παίζει άλλον ρόλο:
- ως απλή συνάρτηση, το \(2x\) είναι η τιμή, από 0 έως 2, με ίσο βάρος. Ο μέσος είναι στη μέση, στο 1.
- ως πυκνότητα, το \(2x\) είναι το βάρος, και οι τιμές είναι τα \(x\) από 0 έως
- Επειδή το βάρος μεγαλώνει προς τα δεξιά, το σημείο ισορροπίας πάει δεξιά από το κέντρο 0.5, στο \(2/3\).
Είναι ακριβώς η αλλαγή ρόλου του άξονα \(y\) που είδαμε στη μετάβαση. Η διακύμανση της πυκνότητας είναι \(\int_0^1 x^2 \cdot 2x\,dx - (2/3)^2 = 1/2 - 4/9 = 1/18\).
5. Πόσο βάρος στη ζώνη. Στην \(N(0, 1)\), τι ποσοστό του βάρους βρίσκεται στη ζώνη \(\mu \pm \sigma\) και τι ποσοστό στη ζώνη \(\mu \pm \text{ΜΑΑ}\); Χρειάζεται ένα ολοκλήρωμα της πυκνότητας σε καθεμία.
Λύση
Το βάρος σε μια ζώνη είναι το εμβαδόν κάτω από την \(f\) σε αυτή:
Κώδικας
c(`μ ± σ`   = integrate(f, -1, 1)$value,
  `μ ± ΜΑΑ` = integrate(f, -sqrt(2 / pi), sqrt(2 / pi))$value)
    μ ± σ   μ ± ΜΑΑ
0.6826895 0.5750625
Περίπου 68% στο \(\mu \pm \sigma\) και 58% στο \(\mu \pm \text{ΜΑΑ}\). Η δεύτερη ζώνη είναι στενότερη, γιατί \(\text{ΜΑΑ} \approx 0.8\,\sigma\).
Γλωσσάρι
| Ελληνικά | Αγγλικά |
|---|---|
| ορισμένο ολοκλήρωμα | definite integral |
| τιμή | value |
| βάρος | weight |
| μέσος όρος | mean |
| σταθμισμένος μέσος όρος | weighted mean |
| μέση απόλυτη απόκλιση (ΜΑΑ) | mean absolute deviation (MAD) |
| διακύμανση | variance |
| τυπική απόκλιση | standard deviation |
| πυκνότητα πιθανότητας | probability density function (PDF) |
| κατανομή πιθανότητας | probability distribution |
| ομοιόμορφη κατανομή | uniform distribution |
| κανονική κατανομή | normal distribution |
| τυπική κανονική κατανομή | standard normal distribution |
| τριγωνική κατανομή | triangular distribution |
Συντελεστές
Συγγραφή: Kostas Maistrelis (ORCID 0000-0002-0851-2866). Το κείμενο, οι εικόνες και ο κώδικας R αναπτύχθηκαν σε συνεργασία με το Claude της Anthropic.
Γλωσσική επιμέλεια: Codex της OpenAI.
Άδεια χρήσης
Το κείμενο και οι εικόνες διατίθενται με την άδεια Creative Commons Αναφορά Δημιουργού 4.0 (CC BY 4.0): μπορείς να τα χρησιμοποιήσεις, να τα αλλάξεις και να τα μοιραστείς, αρκεί να αναφέρεις την πηγή. Ο κώδικας (τα scripts R, το Makefile και τα κομμάτια κώδικα του κειμένου) διατίθεται με την άδεια MIT.
Κάθε πιθανότητα είναι από 0 έως 1, και η πιθανότητα του συνόλου όλων των δυνατών αποτελεσμάτων είναι 1. Στη διακριτή περίπτωση αυτό εκφράζεται ως άθροισμα πιθανοτήτων· στη συνεχή περίπτωση το αντίστοιχο είναι ολοκλήρωμα. ↩︎
Αφήστε ένα σχόλιο
Τα σχόλια ελέγχονται πριν δημοσιευθούν και εμφανίζονται με την επόμενη ενημέρωση του ιστότοπου.